Microprueba de rendimiento como práctica del ciclo de vida del desarrollo de software
¡Sigan así! La práctica de microbenchmark en el ciclo de vida del desarrollo de software
Mientras desarrollamos software, muchas veces desarrollamos una solución correcta pero siempre pasamos por alto los requerimientos no funcionales (especialmente rendimiento y seguridad).
Este es el primer caso:
Estábamos rastreando un problema en una cadena de llamadas en una aplicación Java que ya estaba optimizada en el pasado, pero resulta que el volumen de datos cambió, por lo tanto, los parámetros estaban ligeramente desactualizados.
La solución fue tan simple como aumentar el buffer a 64KB en una llamada para encajar todo el archivo json en un objeto Java BufferedReader.
Aunque no tuvimos mucho tiempo para analizarlo más a fondo, mi hipótesis personal es que la aplicación Java estaba llamando a la syscall de Linux read bastante veces en lugar de una sola lectura que obtenga todo el contenido del archivo.
La mejora de rendimiento fue significativa, una llamada que tomaba varios milisegundos, a veces llegando hasta segundos y bloqueando los Quarkus/Vert.x workers, ahora realiza toda la cadena de llamadas en menos de 60 milisegundos.
Siguiendo ese caso, rastreamos otra cadena de llamadas en C++ relacionada con este primer caso.
Otra vez, esta aplicación C++ estaba bien ajustada en el pasado y siempre funcionó como un encanto, pero (hay siempre un pero), notamos que las cadenas estaban concatenadas y que una llamada tenía 2 bucles que podrían unirse en un solo bucle.
Así que escribí este código C++ bastante simple para replicar la situación y hacerle una microbenchmark:
La diferencia de tiempo almacenada en la variable case1 es la escena actual AS-IS, la variable case3 es el TO-BE (la variable case2 era otra variación de la concatenación, omitida para simplificar la lectura de este artículo).
Microbenchmarking este código de muestra, extraje el siguiente gráfico que se lee como "en menos del 95% de los casos, toma n segundos concatenar/apendizar datos usando gcc/clang":
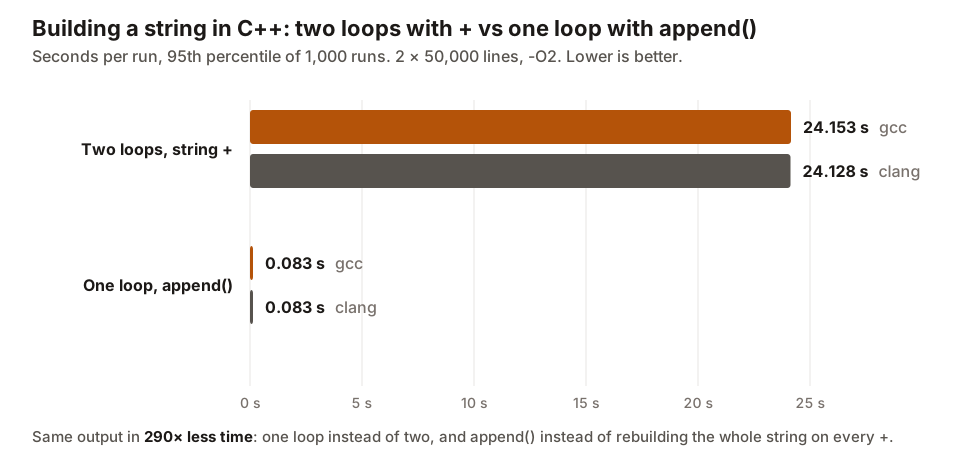
Como podemos ver, los cambios de bucle doble con concatenación a bucle simple con append traen una ganancia de rendimiento significativa y será aplicado en el próximo sprint! :)
Ah, por supuesto, la explicación de este problema de rendimiento es simple: reemplazar 2 bucles por uno reduce el número de iteraciones (O(2n) -> O(n)), reemplazar la concatenación está relacionado con otra cosa: append de cadenas para ser eficiente, usualmente es implementado como una lista enlazada, mientras que las concatenaciones de cadenas son usualmente implementadas copiando todo el arreglo cada vez que se agrega una nueva parte de cadena.
Para resumir, estas son algunas de las conclusiones:
Este es el primer caso:
Estábamos rastreando un problema en una cadena de llamadas en una aplicación Java que ya estaba optimizada en el pasado, pero resulta que el volumen de datos cambió, por lo tanto, los parámetros estaban ligeramente desactualizados.
La solución fue tan simple como aumentar el buffer a 64KB en una llamada para encajar todo el archivo json en un objeto Java BufferedReader.
Aunque no tuvimos mucho tiempo para analizarlo más a fondo, mi hipótesis personal es que la aplicación Java estaba llamando a la syscall de Linux read bastante veces en lugar de una sola lectura que obtenga todo el contenido del archivo.
La mejora de rendimiento fue significativa, una llamada que tomaba varios milisegundos, a veces llegando hasta segundos y bloqueando los Quarkus/Vert.x workers, ahora realiza toda la cadena de llamadas en menos de 60 milisegundos.
Siguiendo ese caso, rastreamos otra cadena de llamadas en C++ relacionada con este primer caso.
Otra vez, esta aplicación C++ estaba bien ajustada en el pasado y siempre funcionó como un encanto, pero (hay siempre un pero), notamos que las cadenas estaban concatenadas y que una llamada tenía 2 bucles que podrían unirse en un solo bucle.
Así que escribí este código C++ bastante simple para replicar la situación y hacerle una microbenchmark:
#include <chrono>
#include <ctime>
#include <iomanip>
#include <iostream>
#include <sstream>
#include <string>

//     g++ -std=c++17 -O2 -o loop__gcctest loop.cpp
// clang++ -std=c++17 -O2 -o loopclangtest loop.cpp

// https://gist.github.com/polaris/adee936198995a6f8c697c419d21f734
static std::string timePointAsString()
{
    auto now = std::chrono::system_clock::now();
    auto in_time_t = std::chrono::system_clock::to_time_t(now);
    std::stringstream ss;
    ss << std::put_time(std::localtime(&in_time_t), "%Y-%m-%d %X");
    return ss.str();
}

int main()
{
    auto w = 50000;
    std::chrono::duration<double> case1, case3;
    std::string str1, str3;

    //std::cout << "starting double loop with concatenation\n";
    auto start = std::chrono::system_clock::now();
    str1 = str1 + "part1\n";
    for (auto x = 0; x < w; x++)
    {
        str1 = str1 + std::to_string(x) + "," + timePointAsString() + "," + "abcdef\n";
    }

    str1 = str1 + "part2\n";
    for (auto x = 0; x < w; x++)
    {
        str1 = str1 + std::to_string(x) + "," + timePointAsString() + "," + "abcdef\n";
    }
    case1 = std::chrono::system_clock::now() - start;

    std::string temp1, temp2;
    //std::cout << "starting single loop with append\n";
    start = std::chrono::system_clock::now();
    temp1.append("part1\n");
    temp2.append("part2\n");
    for (auto x = 0; x < w; x++)
    {
        auto curr_time = timePointAsString();

        temp1.append(std::to_string(x));
        temp1.append(",");
        temp1.append(curr_time);
        temp1.append(",");
        temp1.append("abcdef\n");

        temp2.append(std::to_string(x));
        temp2.append(",");
        temp2.append(curr_time);
        temp2.append(",");
        temp2.append("abcdef\n");
    }
    str3.append(temp1);
    str3.append(temp2);
    case3 = std::chrono::system_clock::now() - start;

    std::cout << case1.count() << ";" << case3.count() << "\n";

    return 0;
}
La diferencia de tiempo almacenada en la variable case1 es la escena actual AS-IS, la variable case3 es el TO-BE (la variable case2 era otra variación de la concatenación, omitida para simplificar la lectura de este artículo).
Microbenchmarking este código de muestra, extraje el siguiente gráfico que se lee como "en menos del 95% de los casos, toma n segundos concatenar/apendizar datos usando gcc/clang":
Como podemos ver, los cambios de bucle doble con concatenación a bucle simple con append traen una ganancia de rendimiento significativa y será aplicado en el próximo sprint! :)
Ah, por supuesto, la explicación de este problema de rendimiento es simple: reemplazar 2 bucles por uno reduce el número de iteraciones (O(2n) -> O(n)), reemplazar la concatenación está relacionado con otra cosa: append de cadenas para ser eficiente, usualmente es implementado como una lista enlazada, mientras que las concatenaciones de cadenas son usualmente implementadas copiando todo el arreglo cada vez que se agrega una nueva parte de cadena.
Para resumir, estas son algunas de las conclusiones:
- Siempre hacer que los recursos (CPU, memoria, disco, hilos, descriptores de archivos, etc.) sean 'ajustables' a través de una configuración externa
- Cada vez que se introduce una nueva funcionalidad, hacerle un benchmark para establecer una línea base
- Si estás cambiando el código actual, presta atención:
- dónde pasa la mayoría de su tiempo el grafo de llamadas de tu aplicación
- a la adición de nuevos bucles (para simplificar las matemáticas, considera cada bucle con un costo de O(n), así que un bucle dentro de otro es O(n^2), un bucle antes/después de otro es O(2n), etc)
- si hay colas en tu código (las colas son muy efectivas para manejar cargas de trabajo no uniformes, pero debes prestar atención a cómo las modelas)
- no saturar recursos con paralelismo, un error muy clásico es asumir que simplemente agregar más hilos y todos los problemas desaparecen, lo cual no es cierto, bastante lo contrario, si saturen hilos, degradarás el rendimiento
- una derivación de lo anterior: agregar más hilos a un solo proceso en lugar de crear más instancias de ese proceso con un número reducido de hilos - agregar más hilos a un proceso dividirá el quantum de tiempo que este proceso tiene en el sistema operativo, si agregas más procesos con menos hilos, en cambio, ganarás más quantum de tiempo del sistema operativo para tus aplicaciones
- No olvides revisar las mejores prácticas de tu lenguaje de programación
- Muy importante: Por favor, agrega microbenchmark como práctica en tu SDLC